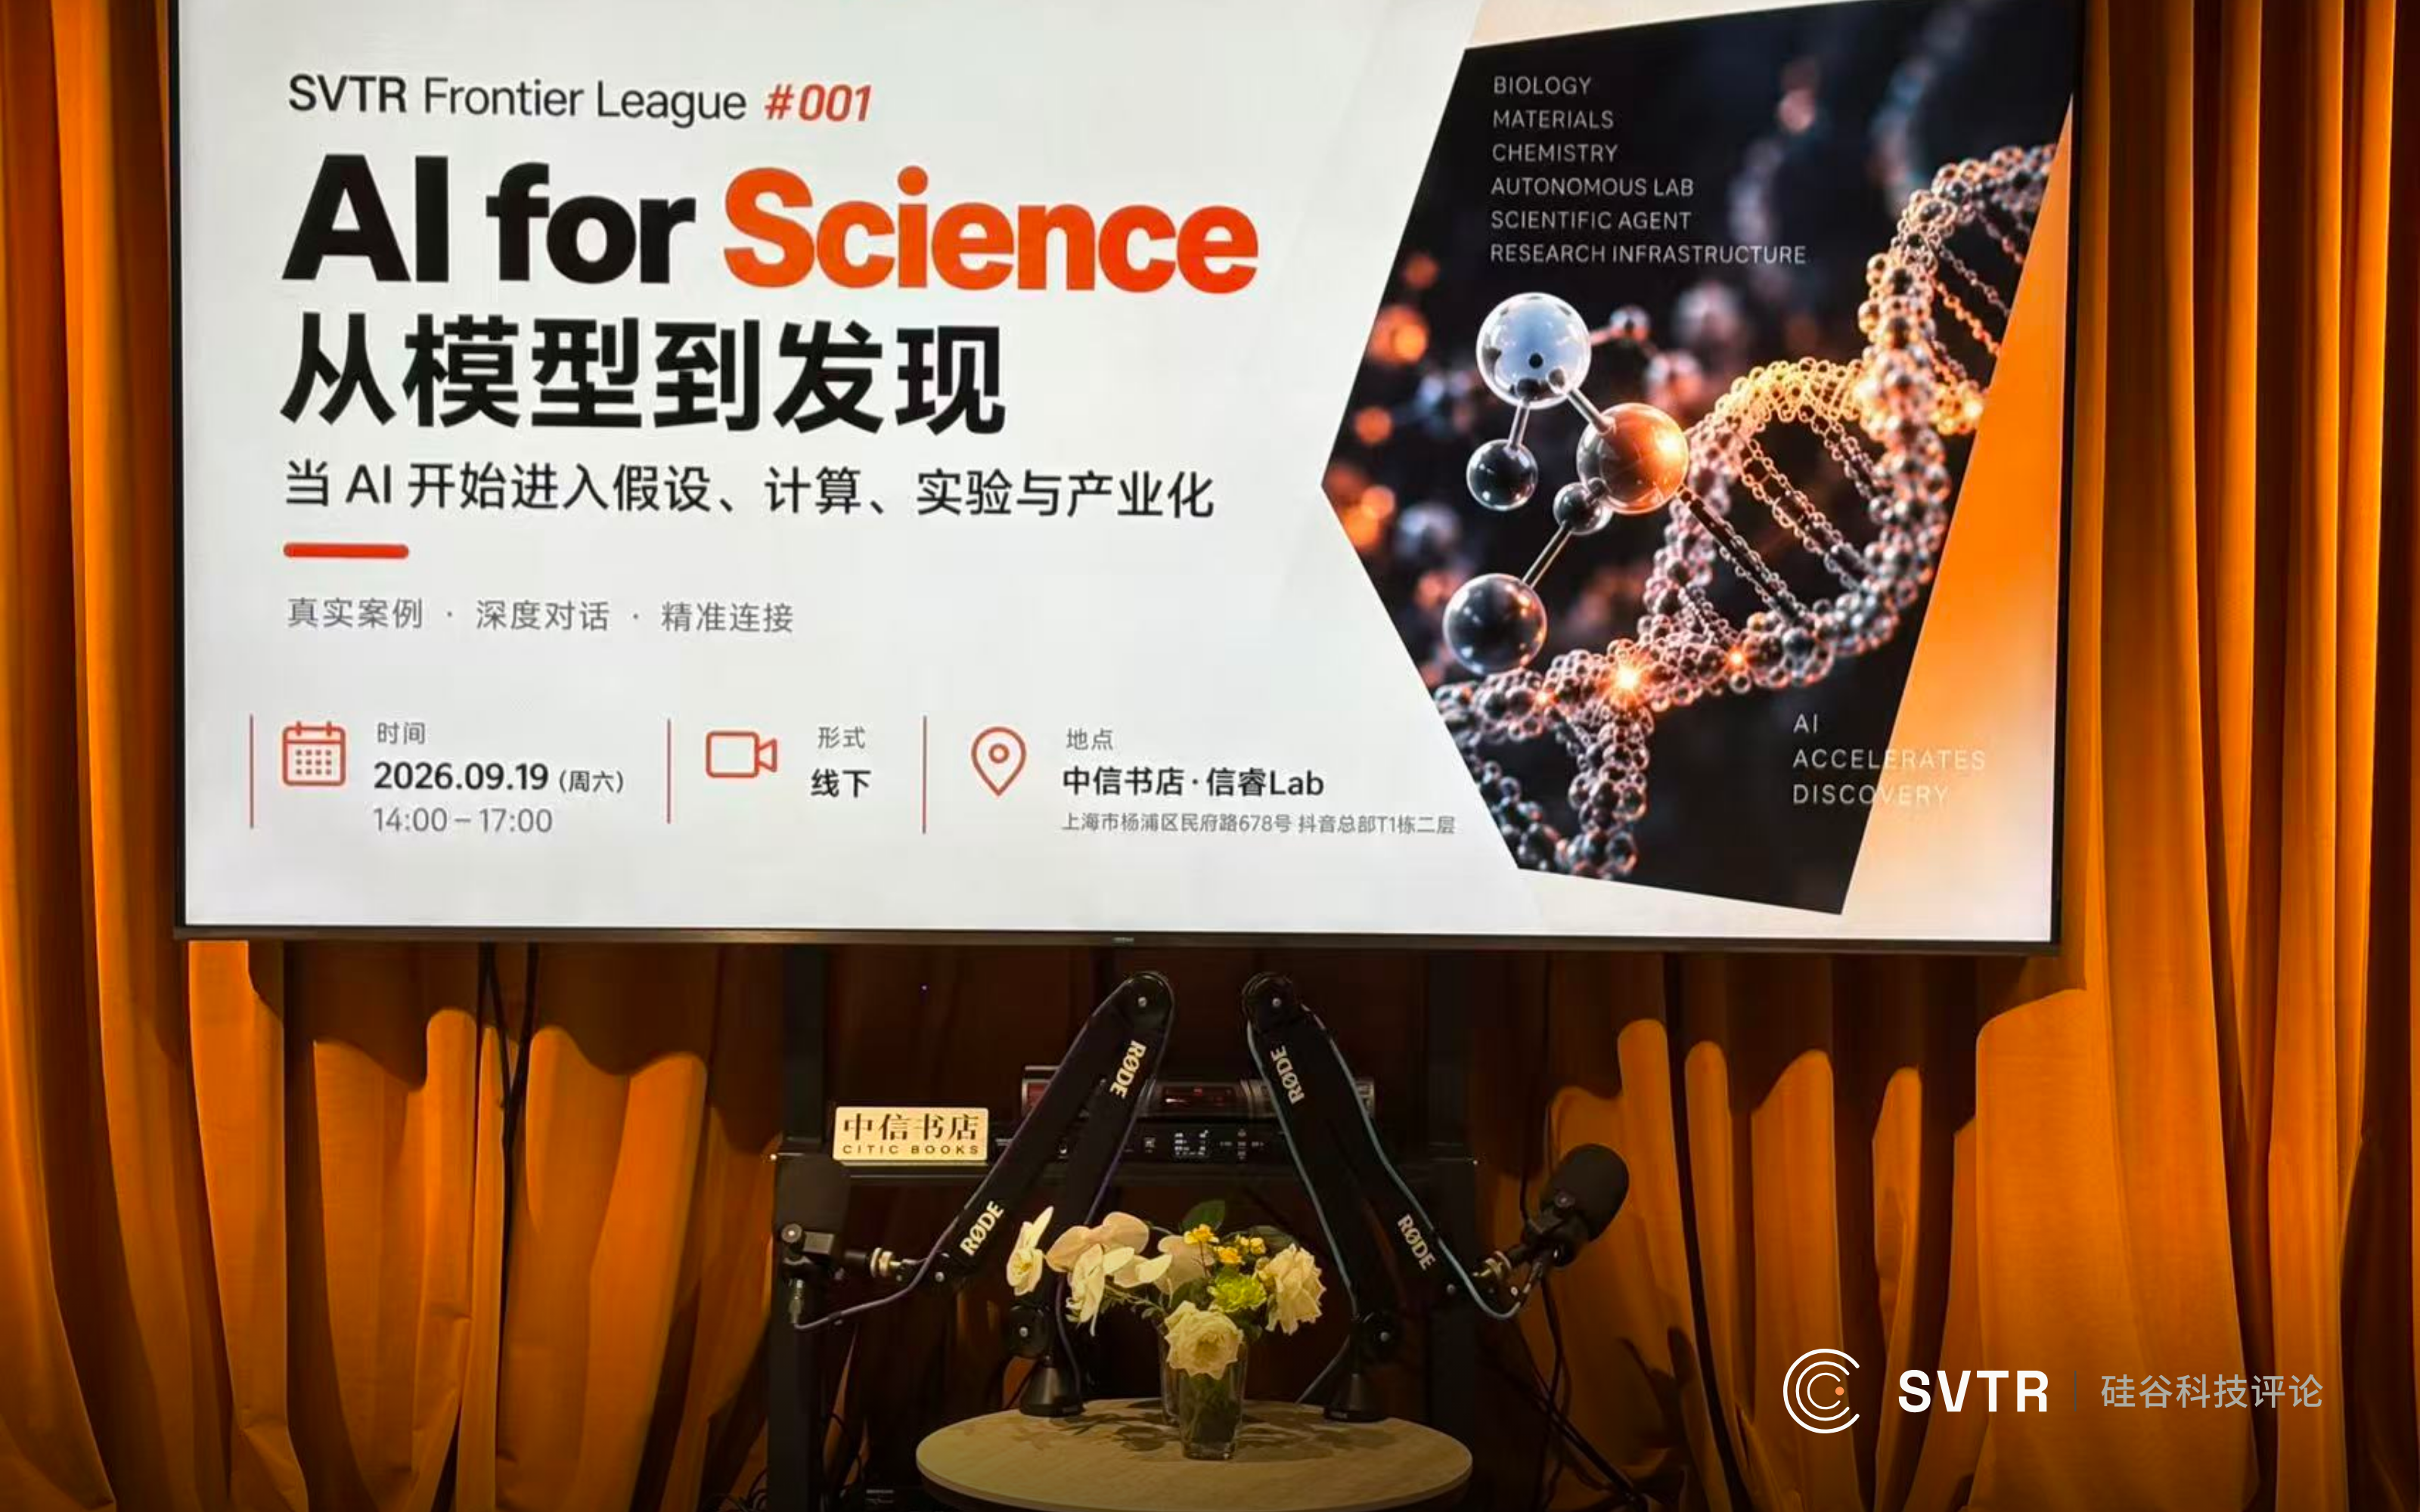
9 月 19 日下午,上海中信书店。SVTR Frontier League 第一期把四个几乎没有交集的行业放到同一张桌子上:电力与水利做工业数字孪生,制造业做物理建模,药物研发做虚拟实验,工程设计做叶片优化。
三位创业者在场,一位学者从香港连线接入。讲到最后,四个人卡住的是同一个地方。

来听物理约束的,有三分之一是投资人
这场会的报名结构本身就是信号:一场讲仿真精度和物理方程的闭门会,超过三分之一的报名者来自投资机构,其余多是创业者和企业研发。
他们想找的显然不是又一个模型,是一个能把护城河说清楚的样本。
第一层:稀疏数据是这些行业的默认状态
上海迅图数码科技创始人闫晨做配电网出身。他回顾说,输电网还能靠传感器全覆盖加人工规则库管住,配电网的设备数量和用户连接规模上去之后,这套就不成立了。团队因此转向用有限的节点数据复刻整个系统的运动。
他举流域的例子:做水动力预测,重点是用节点传感器的数据复刻流域整体运动,不是去算每一滴水的轨迹。Q-MAP 引擎也是这么取舍的:渲染能力对齐游戏级,但主动砍掉毛发、布料这类工业场景用不上的特性,资源全给大规模动态对象的实时渲染与控制。据 SVTR AI 创投库的档案,这家公司 2003 年成立,脱胎于国家电网研究院,图形引擎做了二十多年。
他把这条路径的落点写在投影上:工业 AI 的前提,是先做出“人人可见”的同步闭环数字孪生,才谈得上积累有真实世界结构与物理约束的工业模型,进而得到一个不产生幻觉的工业智能体。

深刻启智创始人凡喜红在制造业遇到同一个约束,说法更直接:很多关键物理量天然难测,或者铺传感器的成本收不回来,数据总量本身构不成瓶颈。他的做法是让热传导、扩散这些物理方程先进来当约束,现场数据只负责校正参数。据其现场表述,这样在数据稀疏时仍能工作,推理过程也能跟工艺和设备控制逻辑接上。
第二层:企业的系统存了结果,没存为什么
真正让四个人汇到一起的是下一层。
香港城市大学系统工程系研究员姜朔做工程设计。他说现有工业软件记录文档、审批、供应链和管理信息,但 AI 要的是设计师每次选择背后的意图:方案为什么被否决,约束条件什么时候改,性能、成本和制造工艺之间怎么取舍。这些通常散在会议和个人经验里。
蜂旭虚拟实验室(Foxu.AI)创始人许可在制药那边给出几乎一样的清单。他认为即便大型药企也仍属稀疏数据环境,因为有价值的不只是单次实验结果,还包括项目是成功、失败还是终止,各阶段的关键决策,以及专家在什么上下文下改的判断。他们的策略因此落在持续接进正在发生的研究上:向 CRO 和 Biotech 提供产品与服务,数据从服务里长出来,不靠采购。
闫晨补了最锐的一刀:工业和社会管理系统里的数据不只是缺,还可能有偏差、口径不一致,甚至被人为调整。底层数据不可信,模型再复杂、算力再足,输出也不能当决策依据。
三段话并在一起,指向同一件事:企业过去的系统擅长保存结果,而 AI 要的是过程里的那些选择。
第三层:产品要知道什么时候停下来
许可的案例最具体。临床统计里如果患者入组日期只有不完整信息,模型不能自己补一个再往下推,系统应该识别出数据不完整,把判断交给临床、申办方或监管相关的人。
他把可靠性拆成四件事:知不知道自己结论的适用边界,能不能复现计算,有没有保留输入、规则、版本和中间过程,不确定时会不会拒答并上报。
姜朔从工程那边给了另一个理由。AI 长期在纯虚拟环境里自我优化,容易对单一指标过度收敛,拿到理论最优、工程上却造不出来的方案。所以工程师的判断仍不可替代:何时用低成本代理模型,何时切到高保真仿真,何时必须进实物测试。
第四层:让交付方和客户站到同一边
凡喜红讲商业模式那段很实。他投影上写的是一句话:可持续交付靠利益对齐。
具体是两件事扣在一起。一是按量收费,收入与客户产出直接挂钩:客户生产越稳定、良率越高,付费意愿越强,交付方也就必须持续关心长期运行效果,而不是卖完即走。二是他叫 dCOA 的数字工艺与质量凭证,每一次模型介入带来的工艺改进都被记录、核验并签发成证书,让工艺确定性可追溯、可证明、可交易。质量证明从事后抽检加静态表格,变成全过程的数据化证明,客户的付费决策有据可依,交付方的持续投入也有据可查。
他给这套逻辑的结论是:AI 不再是产线上的附加工具,而是客户愿意持续付费的生产力单元。

但他认为落地最大的障碍不在模型。据其现场表述,多数项目卡在组织愿不愿意改工作流,传统企业里改一个数据页面都要走需求、审批、开发、测试几层。他还提醒一句:客户部署了大量工业软件,不等于具备 AI 落地条件。那些系统积累的是管理数据;AI 需要的过程数据、意图数据和异常数据,通常一条都没留下。
这场会之后,我们怎么看这条赛道
判断很明确:AI for Science 项目能不能跨客户复制,先看客户有没有产生数据的能力,再看模型。
四位嘉宾的行业完全不同,护城河的位置却指向同一处:公司有没有嵌进客户产生数据的那个环节。只买静态数据库的公司,和每天接进实验、设备、仿真与客户操作的公司,几年之后手里的资产完全不同。
这跟我们会前那篇的判断接得上。截至 2026 年 9 月 9 日,SVTR AI 创投库 AI4S 标签下的公司过去 12 个月共 118 笔已确认融资,其中 13 家拿到单笔过亿美元的公司分走了 73% 的已披露资金。资本在给“别人短期做不出来”定价;而现场告诉我们,最难被复制的那类能力,往往不在模型参数上,在数据的位置上。
对看这条赛道的基金,下一个尽调问题也就清楚了:这家公司的数据是买来的,还是长出来的。
AI4S 的完整融资数据见《AI4S 的估值,在结果出来之前就开始分层》,本期活动详情见SVTR Frontier League #001|AI for Science:从模型到发现。
下一次再看这批公司,我们会重点跟三件事:谁在持续获得新数据,谁开始进入客户的日常工作流,谁能把实验和工程结果变成长期收入。
本次活动非常感谢中信书店-信睿 Lab 的鼎力支持,我们未来会有更多的深度合作内容,敬请期待。
SVTR Frontier League 每期聊一个前沿方向,面向全球 AI 创业者与投资人。欢迎加入我们,一起聊聊。